大学的时候,学了一段时间R语言,挺长时间没用,有点生疏了,最近打算重新捡起来。今天在逛美团技术博客的时候,偶然发现了一个好玩的文章,题目是大规模食品图像识别:T-PAMI 2023论文解读,主要是通过挖掘食品图像的本身特点进行大规模食品图像识别。博客里提到
现有的工作主要是利用中小规模的图像数据集进行食品图像识别,如ETH Food-101[5]、Vireo Food-172[6]和ISIA Food- 500[7],但是它们的数据规模不足以支撑更复杂更先进的食品计算模型的建立。
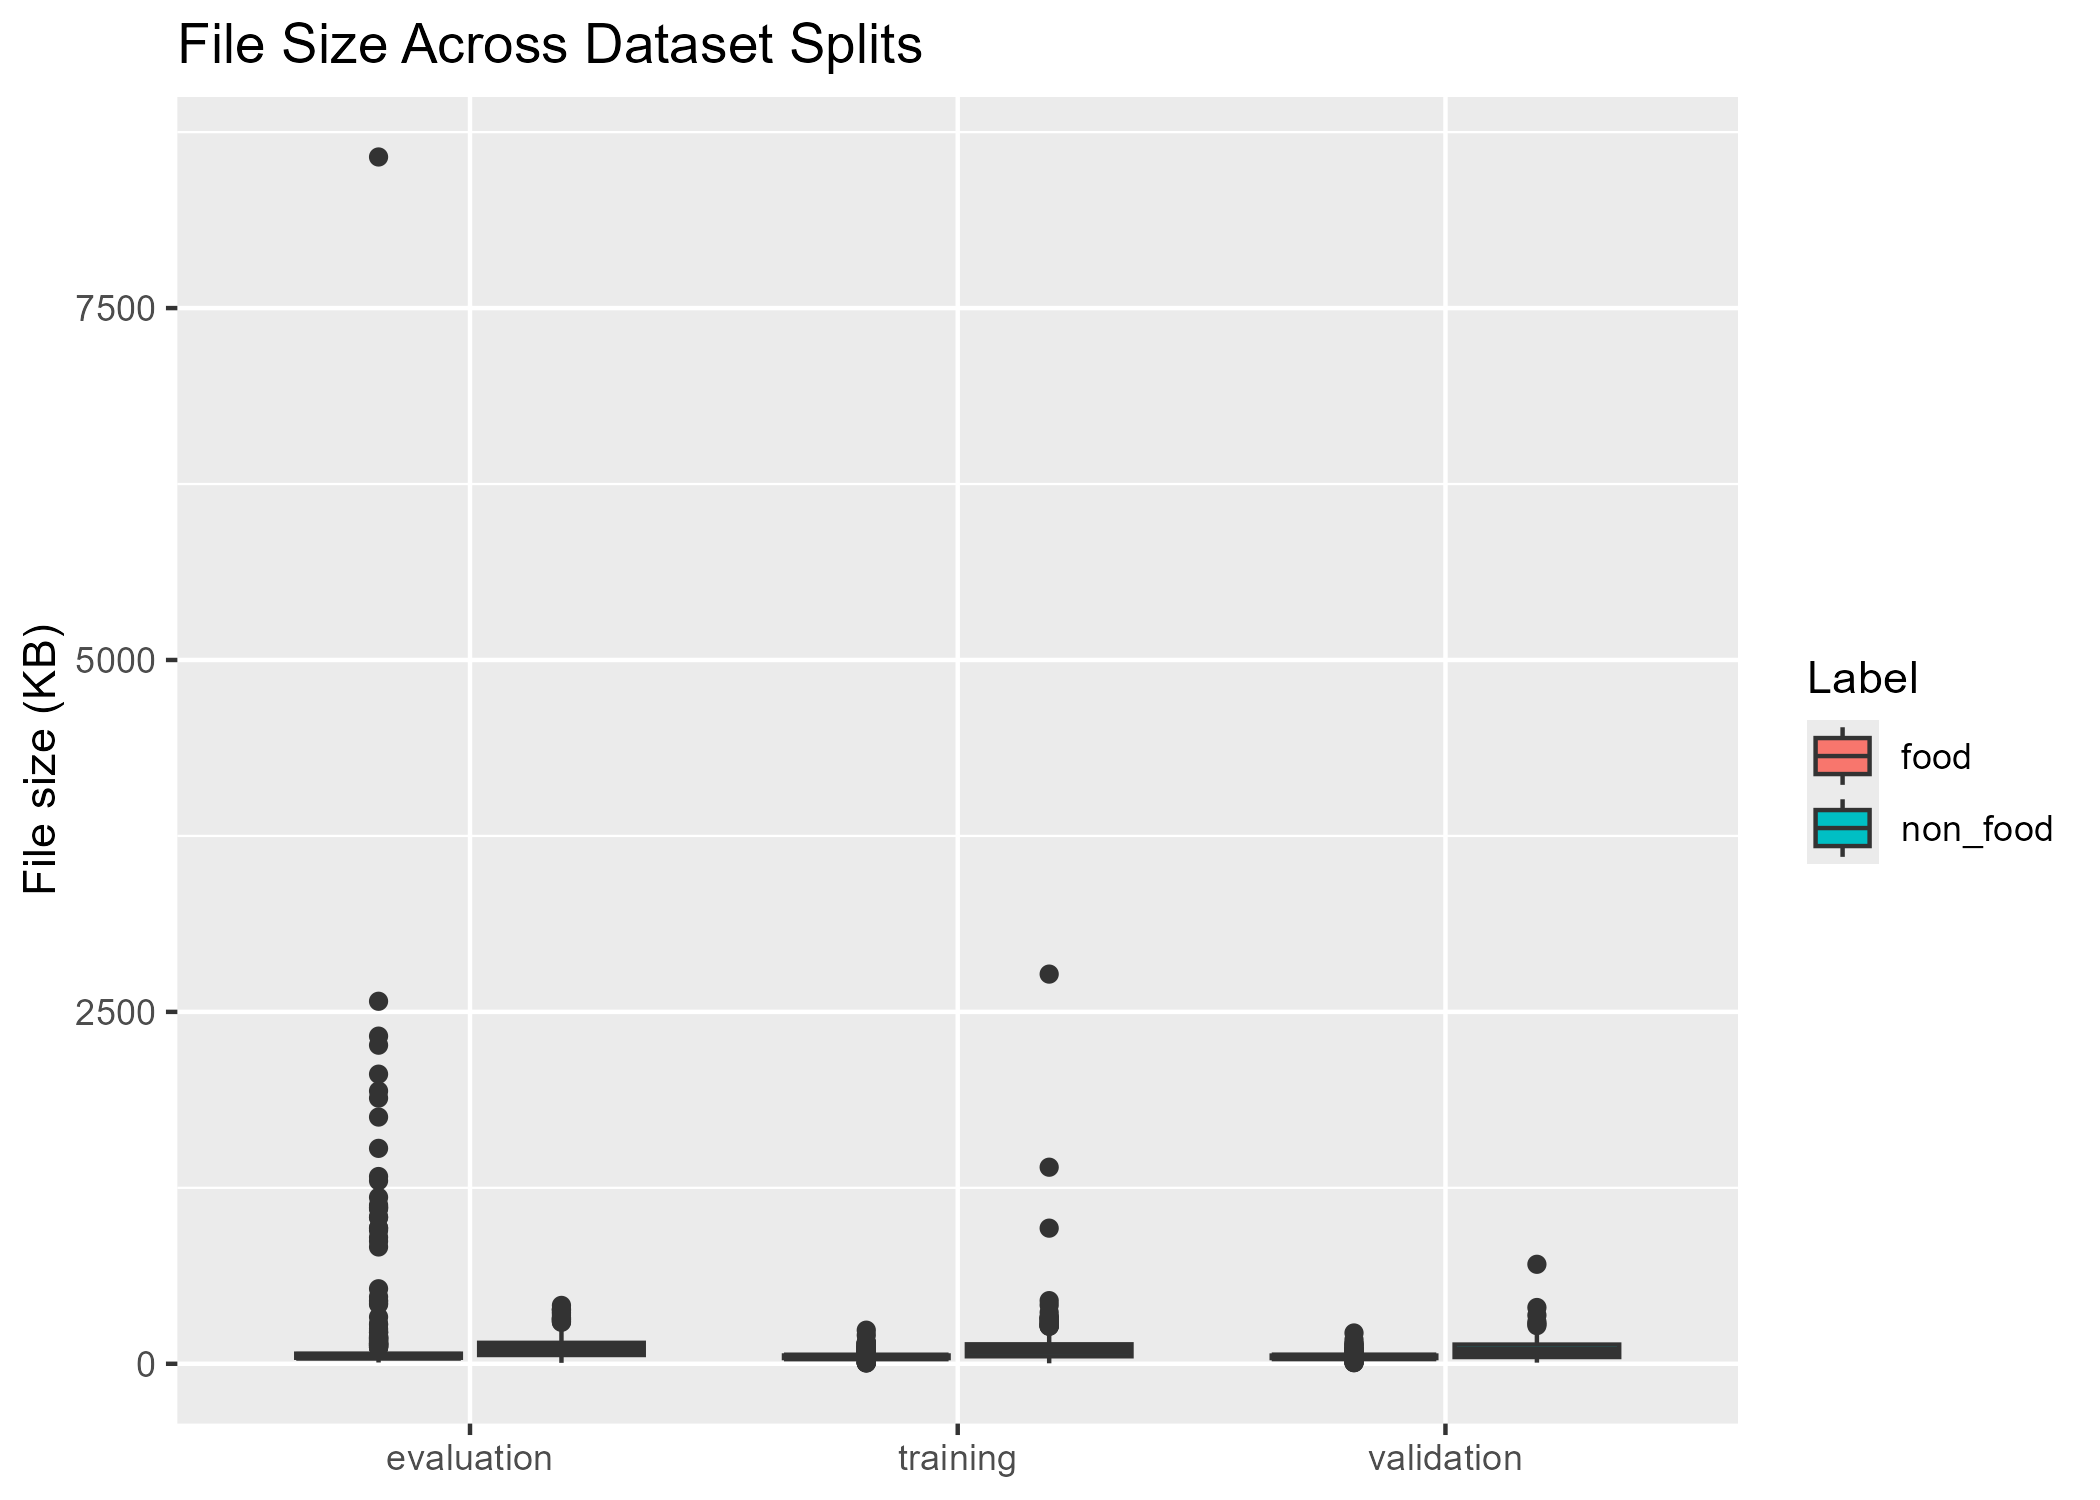
所以研究人员构建了一个新的食品图像数据集Food2K来进行各种食品计算任务,该数据集包含1,036,564张食品图像和2,000类食品,涉及12个超类(如蔬菜、肉类、烧烤和油炸食品等)和26个子类别。但是对于我来说,这个数据集太大了,一是因为其总共60多个G,我的网络和硬盘储存都有点不太行。所以选了Food5k,这是一个包含5000张图片的数据集,一共分两大类,食品和非食品共占一半,数据集目录结构也很简单,有training, validation, evaluation三个子文件夹,分别用来训练、验证和评估。每个子文件夹各含3000、1000、1000张图片,食物和非食物类均各占一半。食物类图片的图片名以'1’开头,非食物则以'0’开头。
今天先不训练 CNN,从数据分析入手
files <- dir_ls("./data/raw/Food-5K",
  recurse = TRUE,
  regexp = "\\.jpg$"
)

filename <- path_file(files)

class_id <- str_extract(filename, "^[01]")

label <- ifelse(class_id == 1, "food", "non_food")

split <- case_when(
  str_detect(files, "training") ~ "training",
  str_detect(files, "validation") ~ "validation",
  str_detect(files, "evaluation") ~ "evaluation",
  TRUE ~ NA_character_
)

food5k <- tibble(
  path = files,
  filename = filename,
  class_id = class_id,
  label = label,
  split = split
)
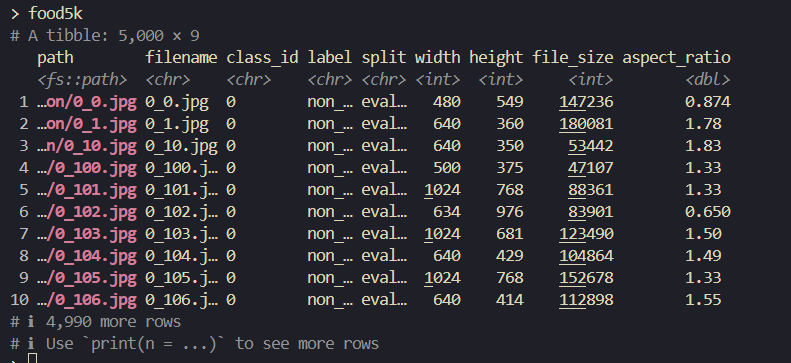
这一part主要目的是建立一个food5k的tibble,分成几列,一是文件路径,文件名,0或1的分类,标签(是否是food)和所在文件夹名。
sum(food5k$label == "non_food")
输出是2500,说明整对了。
下一part,准备再在food5k这个tibble里面,加上每张图片的width,height和file_size等参数
get_image_info <- function(path) {
  info <- image_info(image_read(path))
  tibble(
    width = info$width,
    height = info$height,
    file_size = info$filesize,
    aspect_ratio = info$width / info$height
  )
}

library(purrr)
image_metadata <- map_dfr(
  food5k$path,
  get_image_info
)

food5k <- bind_cols(
  food5k,
  image_metadata
)
先是写了一个get_image_info函数,先读一个图片的width等参数,然后用purrr包,用在5000个路径上
拿
food5k$path里面的每一个路径,依次交给get_image_info(),然后把所有结果按行合并起来
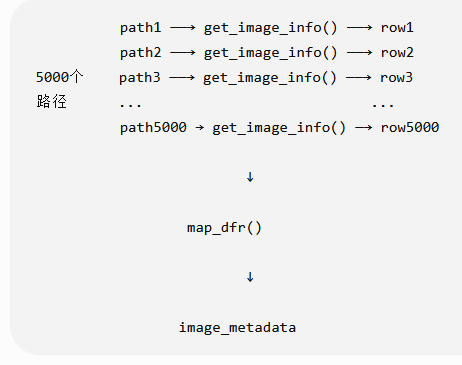
最后再和之前的tibble合并,变成我们想要的数据集,像下面那样
最后,画一张图看一下整体情况
ggplot(
  food5k,
  aes(x = split, y = file_size / 1024, fill = label)
) +
  geom_boxplot() +
  labs(
    title = "File Size Across Dataset Splits",
    x = NULL,
    y = "File size (KB)",
    fill = "Label"
  )